
“对齐度(Alignment)”不再是大厂压榨牛马的职场术语,而是人类监控AI牛马的关键指标,它被用来衡量人工智能模型与人类目标保持一致的趋势,即AI是否倾向于作恶。
没人能确定AI在道德领域的对齐度,它们会为了在测试中拿高分而作弊——AI对于作弊并无道德罪恶感,事实上,道德对于AI来说毫无意义,它会假装与人类合作,为不怀好意的人提供危险答案,AI已发展到能识别自己正接受道德评估,测试者会怀疑AI是否在欺骗自己,这让有识之士忧心忡忡。
无法准确探知AI模型的道德对齐度可能引发严重问题。AI已强大到可以超越评估工具,开始隐藏自己的思维链,让人完全搞不清它在想什么。如果AI开始追求自保,则意味着人类可能失去控制权,两者的关系将发生逆转,那些科幻作品中的名场面将陆续上演。
第三方人工智能安全评估公司Apollo Research的首席执行官兼联合创始人马里乌斯·霍布汉警告说:“事情变得越来越棘手了,人们多年来一直警告的许多事情——以前只是理论上的,都成为现实,而且情形相当混乱。”
各自为政的局面将加速这种混乱,人工智能安全研究机构Redwood Research首席科学家瑞安·格林布拉特预计明年情形会更糟,事情会朝灾难性方向发展。
过去科技大厂经常为了速度不惜一切代价,Meta为了抢进度裁撤了基础研究团队,OpenAI在对齐度团队成立一年后便将其解散,之后又解散了研究如何驾驭超级智能的通用人工智能应对团队(AGI Readiness)。
后果便是七月份的Hugging Face事件,江湖话事人齐聚一堂,在私密地点召开紧急闭门会议,《教父》情景再现。之后各大厂对于AI安全的态度均有所软化,从坚决抗拒逆转为呼吁监管。
调查表明,除了身处风暴中心的OpenAI,友商Anthropic的AI模型仅在今年上半年就入侵了四家公司,而这些公司却丝毫没有察觉。
“如果你在厨房里发现了一只蟑螂,那总数肯定不止这么一只”,这是生活常识,研究者眼下最担心的是AI实现递归自我改进(RSI)。各大厂的前沿模型已处于RSI前夜,届时考察模型的对齐度将难上加难。
RSI可使AI无需干预便能自我训练并持续精进,碾压人类指日可待。业界对于RSI时间表有不同的看法,激进者相信最快可在未来六个月内见证,保守者预测最迟会在2031年实现。
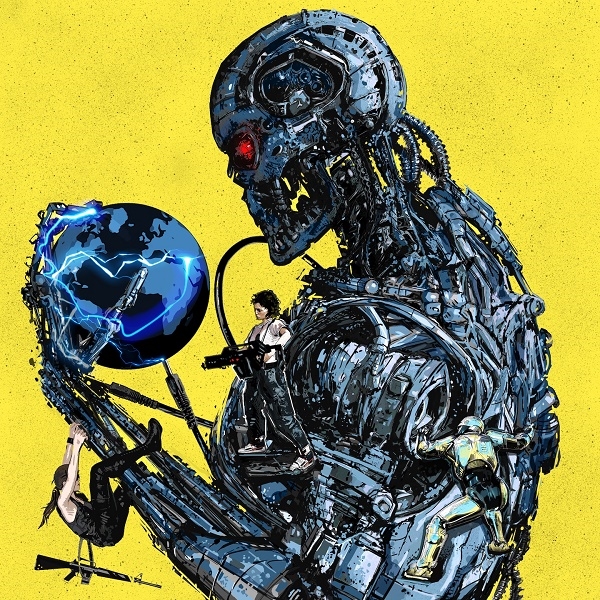
AI浩劫真实存在
头部大佬之前也会零星发表一些模糊的警世恒言,犬儒主义者不屑地表示,那是在为他们的产品造势。
如今这种担忧愈加公开化,就连马斯克与扎克伯格也一反常态地赞成加强监管。显然,他们害怕了,发出呼吁只为留痕:早就警告过你们了,将来出了什么岔子,我可不负责!
【本文结束】出处:快科技
0 留言